我为什么看空 HBF
从权重读取、KV Cache、闪存寿命与 MoE 推理出发,讨论 HBF 的适用边界,以及额外容量为何未必能转化为整机成本优势。
Isaac Dalloway · 技术观察 · 2026 年 9 月
2025 年 7 月,Sandisk 在一份三页的技术说明中提出,HBF 可以在接近 HBM 的带宽和成本下,提供八到十六倍的容量。对于正在为大模型采购硬件的企业,这个承诺很有吸引力:GPU 的算力还没用足,昂贵的 HBM 就已经装满了,继续扩容往往意味着再买几张 GPU。如果闪存真能以接近 HBM 的速度供给数据,这笔开支就有了压缩的余地。
HBF 是 High Bandwidth Flash 的缩写,中文通常译作高带宽闪存。它试图利用 NAND 的容量和成本优势,通过内部并行、堆叠和更宽的接口,让闪存直接参与加速器附近的数据供给。这个思路并不难理解,真正让我产生怀疑的,是 Sandisk 同一份材料末尾的测试说明:所谓接近 HBM 的性能,来自读取 Llama 3.1 405B 的 8-bit 预训练权重的内部模拟,比较对象则是一套假设容量无限的 HBM 系统。
这个实验回答了特定条件下的权重读取问题,而在线推理还要处理不断到来的请求、持续增长的缓存,以及多年运行中的维护和更换。它们都会改变 HBF 的实际收益。读完支持和质疑这项技术的研究,我的判断是,HBF 不会成为通用推理加速器的主流配置,更可能出现在少数经过专门设计的平台中,解决特定负载的容量问题。将它视为未来 AI 内存普遍需要增加的一层,我认为高估了需求,也低估了系统改造的成本。
要说明这个判断,首先得弄清楚,GPU 旁边多出几百 GB 闪存以后,哪些数据值得放进去,以及它们能否真正让服务器少花钱、多完成工作。
权重放进 HBF 以后
推理服务器加载模型时,首先要为权重分配内存。这些参数在模型运行期间大体固定,同一份权重可以供许多请求共同使用;随着请求到来,系统还会生成 KV Cache,保存注意力计算所需的历史状态,避免重复计算。每一层计算又会产生中间激活、临时缓冲和通信数据,通常很快就会被使用并释放。
这些数据可以相加,用来估算模型运行需要多少内存,但选择存储介质时,必须考虑它们各自的访问方式。权重能够提前加载,KV 随请求增长,临时张量则频繁产生和消失。对它们来说,容量、读取速度和写入能力的重要程度并不相同,这也给 HBF 留下了一个合理用途:保存推理过程中以读取为主的权重。
SK hynix 的 H³ 架构就采用了这样的分工,让 HBF 保存权重和预计算 KV,把动态数据留在 HBM。权重换了存放位置,HBM 仍然可以承担正在使用的 KV、热点数据和计算缓冲,两者在技术上能够配合。因此,对这条路线,我更关心的是权重能否及时读到,以及增加 HBF 后究竟能省下多少整机成本。
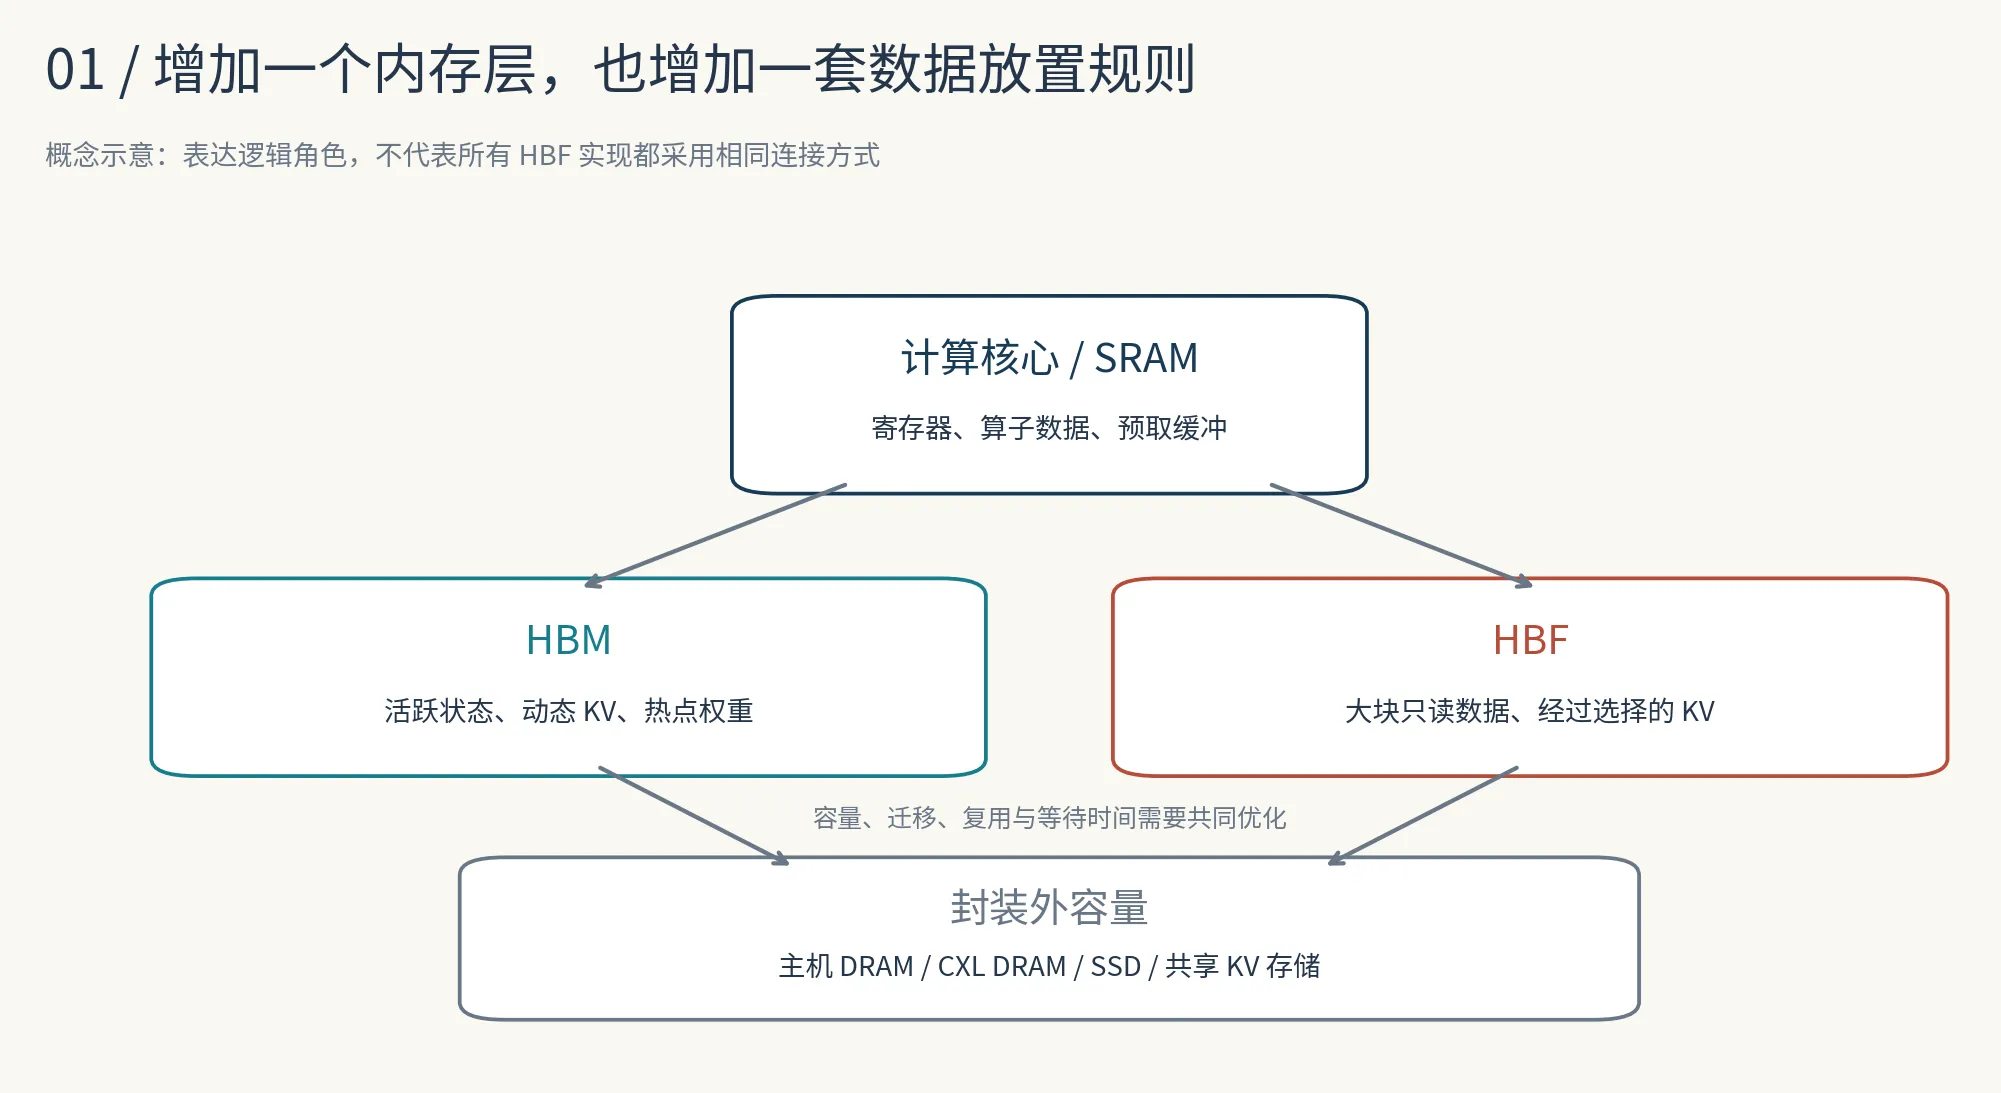
图 1|HBF 与 HBM 的一种数据分工。图中表示逻辑访问关系,实际连接方式随架构而异。
HBM 的价格包含了低延迟、高带宽和频繁读写的能力。HBF 借助 NAND 的密度增加容量,也保留了 NAND 按页读取、按块擦除,以及读写速度不对称的特征。将闪存放到计算芯片附近,可以缩短数据路径、减少接口限制,却不会改变存储单元的基本工作方式。
这就是带宽和延迟需要分别讨论的原因。设备同时处理大量读取,可以在一秒内传输很多数据,但如果后一次读取必须等前一步计算结束才能确定,计算单元仍然会停下来等待。预取能够缓解这种等待,前提是系统足够早地知道下一步要用什么。对一块执行顺序明确的权重,这通常比较容易;对动态路由之后才确定的数据,就需要额外安排。
HBF 要把标称带宽转化为实际性能,还需要将数据分散到足够多的并行单元,减少页面中读出却用不到的内容,并让传输尽量与计算重叠。访问过于零散、负载分布不均或预取失误,都会降低有效带宽。因此,我更看重每秒有多少计算真正需要的数据能够及时送达,产品规格上的 TB/s 只是分析的起点。
这使 HBF 的采用门槛高于单纯增加容量。数据布局、缓存管理和运行时调度都要跟着调整,客户也需要确认,这套改造在自己的模型与请求分布下仍然有效。只有额外容量带来的收益能够覆盖这些投入,HBF 才值得进入整机设计。
KV Cache 应该存在哪里
KV Cache 乍看也适合闪存,因为历史状态生成之后,会被后续 token 反复读取。解码通常只是追加新 token 的 KV,已有历史并不会在每一步完整重写,所以不能拿全部上下文的读取量来估算写入寿命。不过,进入分层缓存以后,每一层实际收到什么数据,比整个模型的读写比例更重要。
正在参与解码的 KV 直接影响下一个 token 何时输出,属于延迟敏感的数据;暂停对话的 KV 可能几分钟后再次使用,也可能再也用不到;系统提示词和共享文档前缀又可能被许多请求反复调用。它们虽然都叫 KV Cache,保存位置和保留时间却需要分别决定。
频繁读取、不能久等的数据适合留在 HBM,暂时不用的内容则可以迁到主机内存、共享内存池或 SSD。HBF 希望承接其中一部分:这些数据太大,长期占用 HBM 不划算,但又经常需要恢复,而且恢复得足够快才能满足服务要求。在我看来,真正符合这些条件的数据,比推理系统产生的 KV 总量少得多。
分层缓存本身还可能进一步削弱 HBF 的收益。系统会尽量把高复用数据留在近端,空间不足时,优先迁走较少使用的内容。于是,远端存储接收了写入,却不一定能等到足够多的再次读取;如果数据直到过期都没有被使用,保存它就只产生了成本。模型整体以读取为主,并不能保证 HBF 所在的那一层也以读取为主。
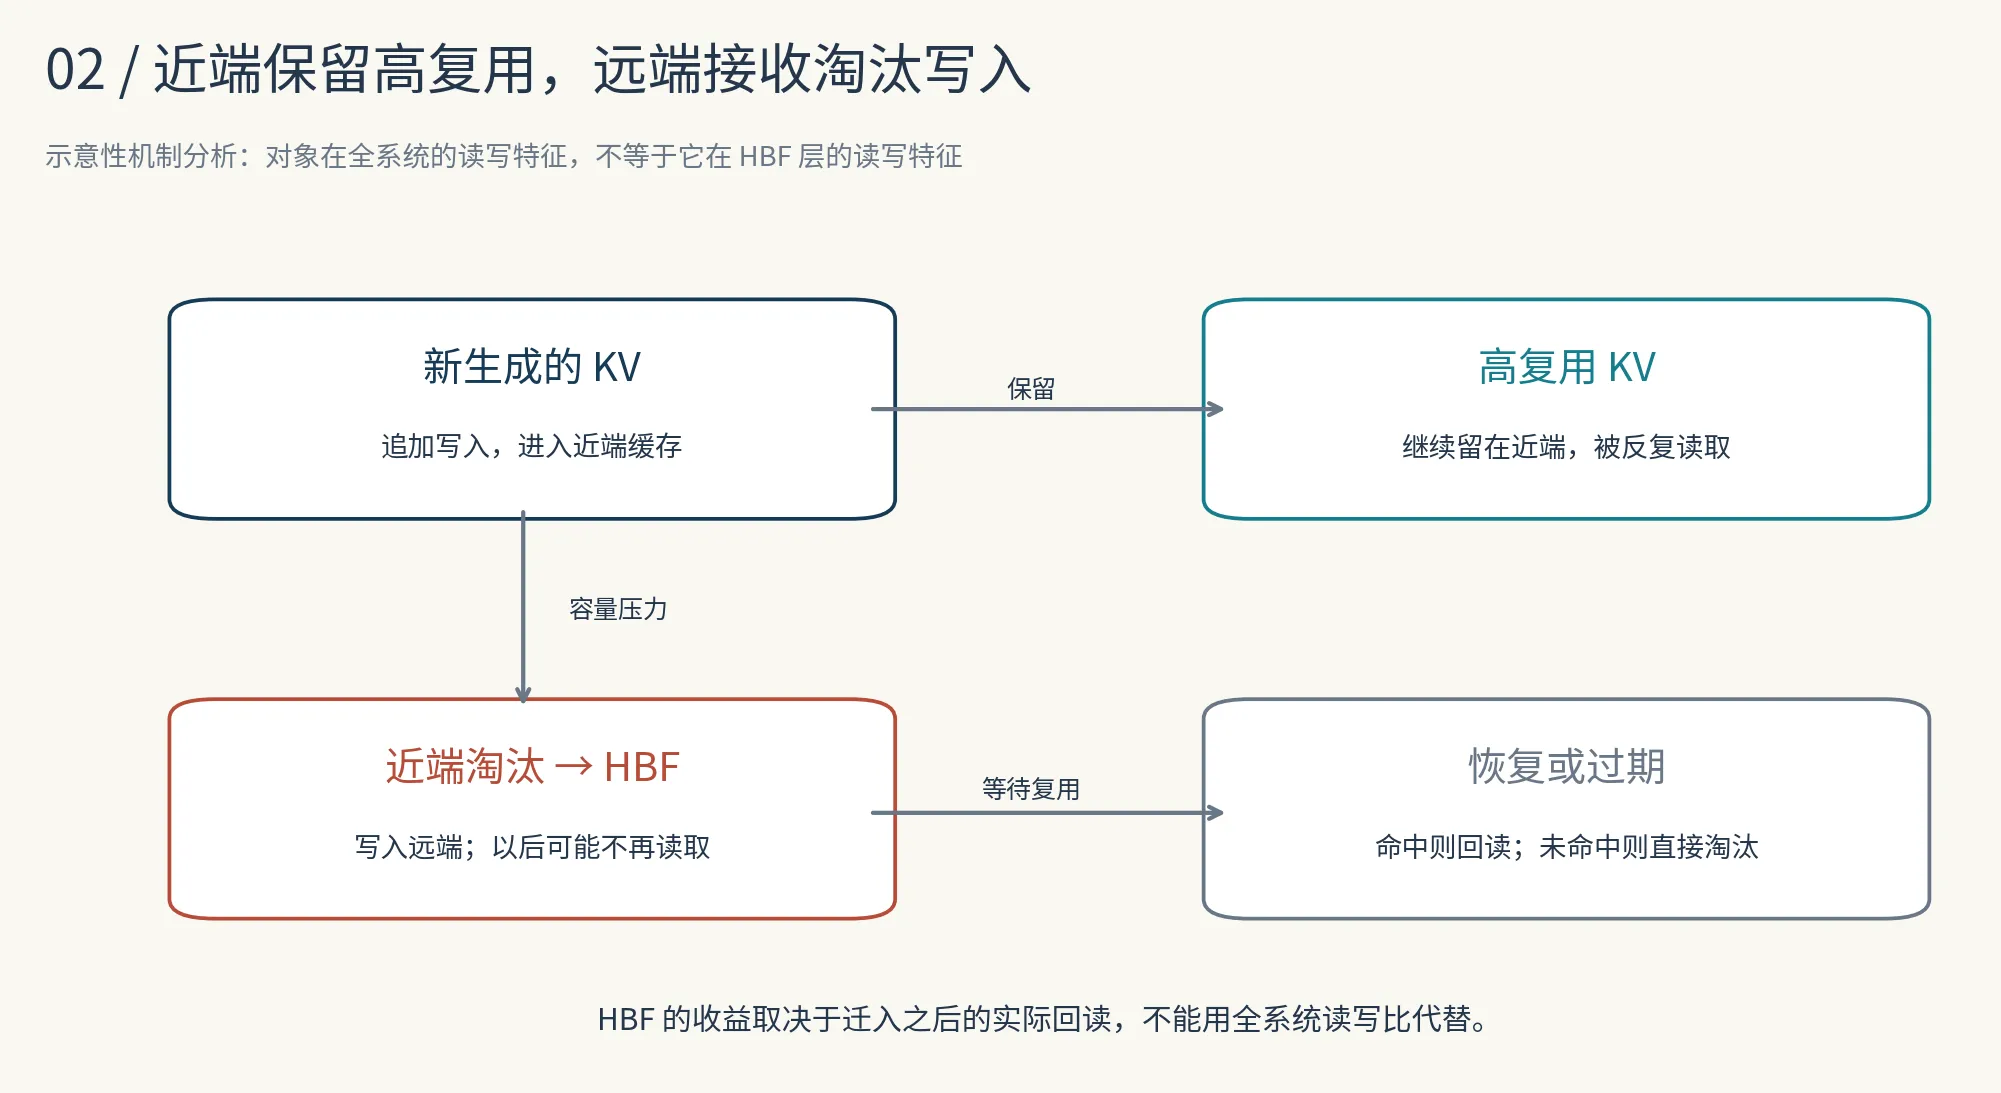
图 2|近端保留高复用数据后,迁入 HBF 的内容可能写多读少。其收益取决于迁入之后的实际复用。
常被称为 HBF Sucks 的那篇全栈评估研究了这一问题。作者用模拟器和生产请求轨迹考察特定的 KV 卸载架构,发现 HBF 方案在减少近端容量与带宽后,承接了写多读少的数据,最终导致服务性能下降。在这个系统中,远端读取的改善不足以补偿近端资源的损失。
这项结果对我的判断很重要,因为它说明,评价 HBF 必须同时检查新增了什么、减少了什么。实验针对的是特定架构,但其中的资源取舍具有普遍意义:如果权重和活跃 KV 仍然需要放在 HBM,可同时处理多少请求,就依然受到 HBM 的限制。远端存下更多数据,对正在执行的任务未必有多大帮助;若为了增加远端容量还削减了近端资源,效果甚至可能倒退。
换成中间 Activation,情况也不乐观。这些张量往往生命周期短、写入频繁,很快就要交给后续计算使用,放进闪存通常还需要额外的搬运和缓冲。至于向量数据库,也不能仅凭数据量大就认定适合 HBF:批量扫描可以利用并行读取,图索引遍历则可能受制于小块随机访问和先后依赖。市场规模很大,最终适合 HBF 的访问模式仍然需要逐项筛选。
寿命会怎样改变成本
保存低频更新的权重时,HBF 的写入寿命压力相对有限;接收持续产生的动态 KV 以后,需要考虑的就是几年运行下来究竟能写多少数据。闪存有有限的编程、擦除次数,读取虽然通常不会直接消耗同样的 P/E 次数,读扰动、数据保持和纠错维护却可能引入额外操作。靠近高功耗加速器的温度环境,也会影响这些维护要求。
可以用一个简单例子理解这个约束。假设 HBF 有 1 TB 物理容量,可用 P/E 次数为 3,000,计划运行五年,写放大为 2,那么平均允许的主机写入速率约为 9.5 MB/s。这是一组用于分析的假设,实际产品需要代入自己的规格;它说明,即使读取带宽达到 TB/s,长期写入能力仍然可能受到严格限制。
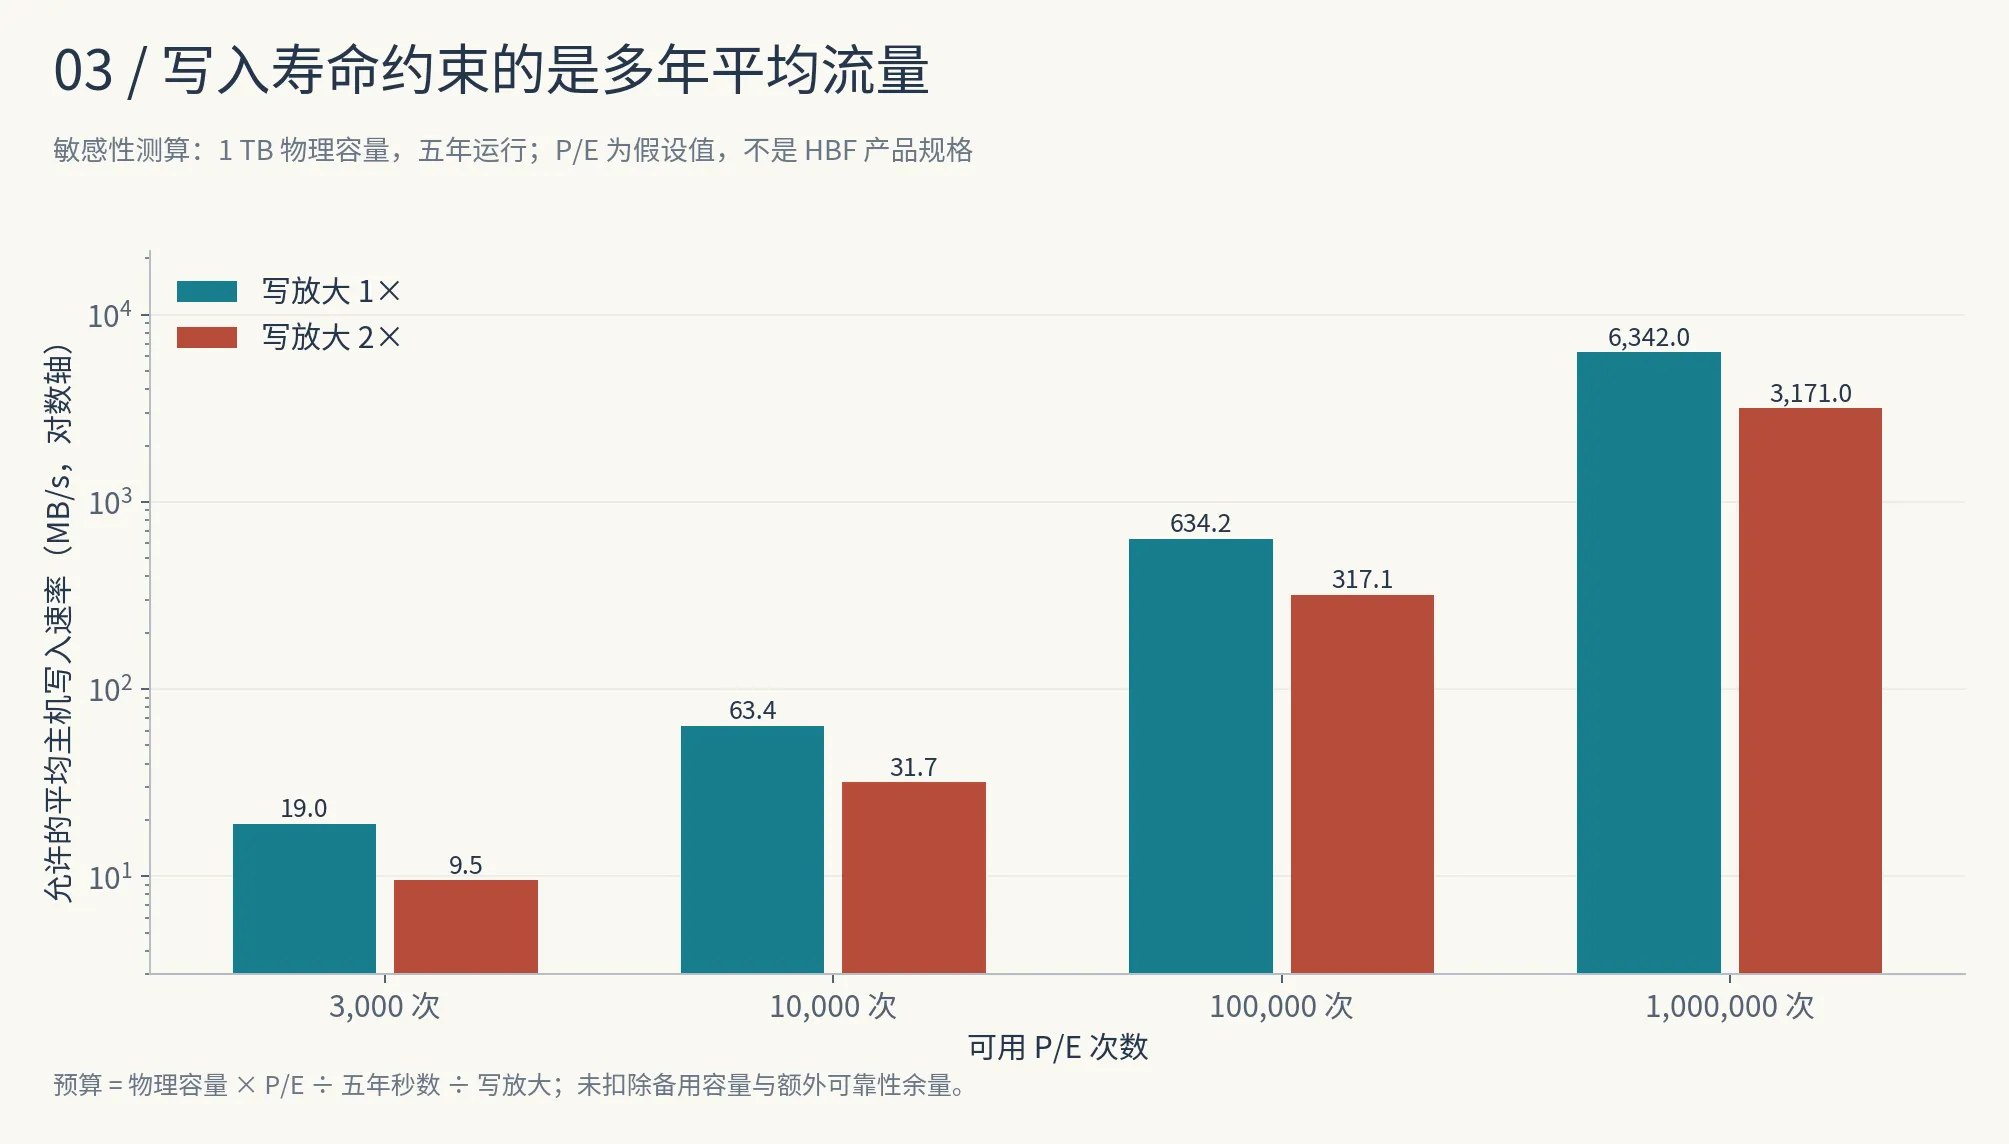
图 3|1 TB 物理容量、五年运行期限下的平均写入预算。P/E 和写放大取不同假设值,纵轴为对数轴。
改善耐久性有不少办法,包括使用 SLC、增加冗余、调整编程条件,或缩短要求的数据保持时间,但这些措施也会改变容量、成本和管理方式。SLC 每个单元存一个 bit,TLC 存三个,在单元数量相同的情况下,切换到 SLC 就需要接受密度下降。寿命可以提高,原来的容量和单价却不能直接照搬。
支持 HBF 的 FlashAccel 研究很能说明这种取舍。其模拟采用 SLC,增加 SRAM 缓冲,并配合预取和专门的数据布局;耐久性分析还假设放宽保持要求,将 P/E 从 10 万提高到 100 万。论文报告的吞吐收益,对应的是这一整套配置。
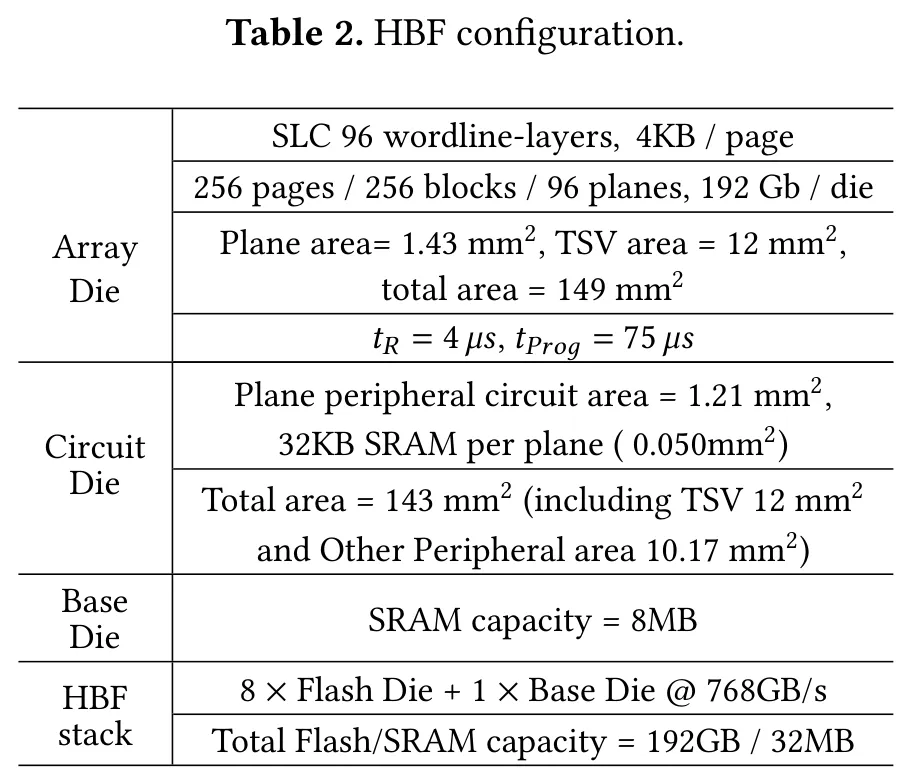
图 4|FlashAccel 原文 Table 2,列出研究使用的 SLC、延迟和 SRAM 缓冲等模拟参数。
我对 HBF 经济性的怀疑,很大一部分来自这些条件之间的关系。讨论中很容易同时引用高密度闪存的容量、普通 NAND 的成本和高耐久配置的寿命,实际产品却必须在同一套设计上兑现它们。只要其中某个指标依赖不同的配置,原先看起来很有吸引力的成本优势就需要重算。
例如,缩短保持时间之后,长期驻留的数据要如何维护;增加备用容量以后,用户实际能用的每 GB 成本是多少;为了管理磨损而增加的控制器、缓冲和验证,又会消耗多少功率和面积。如果 HBF 被紧密集成在加速器封装中,器件老化后的更换方式还会影响整机使用成本。这些问题连在一起,决定了低价 NAND 最后能提供多便宜的可用内存。
因此,我认为按单位 bit 的制造成本判断 HBF,容易高估它对客户的吸引力。服务器需要在整个使用期内持续完成任务,采购时必须同时计算可用容量、运行性能和维护费用。闪存从存储设备进入加速器附近,并不会让这些费用自动减少。
MoE 改变了需求,也增加了变量
我看好大参数 MoE 的长期地位,因为它能够保留庞大的参数集合,同时只让部分专家参与每个 token 的计算。这使总参数规模与单次计算量不再按同样的比例增长,也让内存分析变得更复杂:需要保存多少权重、每一步实际读取多少,以及为并发请求保留多少 KV,必须分别计算。
以 DeepSeek-V3 为例,它有 671B 总参数,每 token 激活约 37B,并通过 MLA 压缩 KV 表示。按 61 层、每层保存 512 维压缩状态和 64 维位置相关状态、每元素两字节计算,每个 token 的 KV 为 70,272 字节,一条 128K 上下文约占 9.2 GB。与数百 GB 权重相比,这个数字确实很小;但在不共享前缀的情况下,32 条序列就需要约 295 GB,128 条约为 1.18 TB。
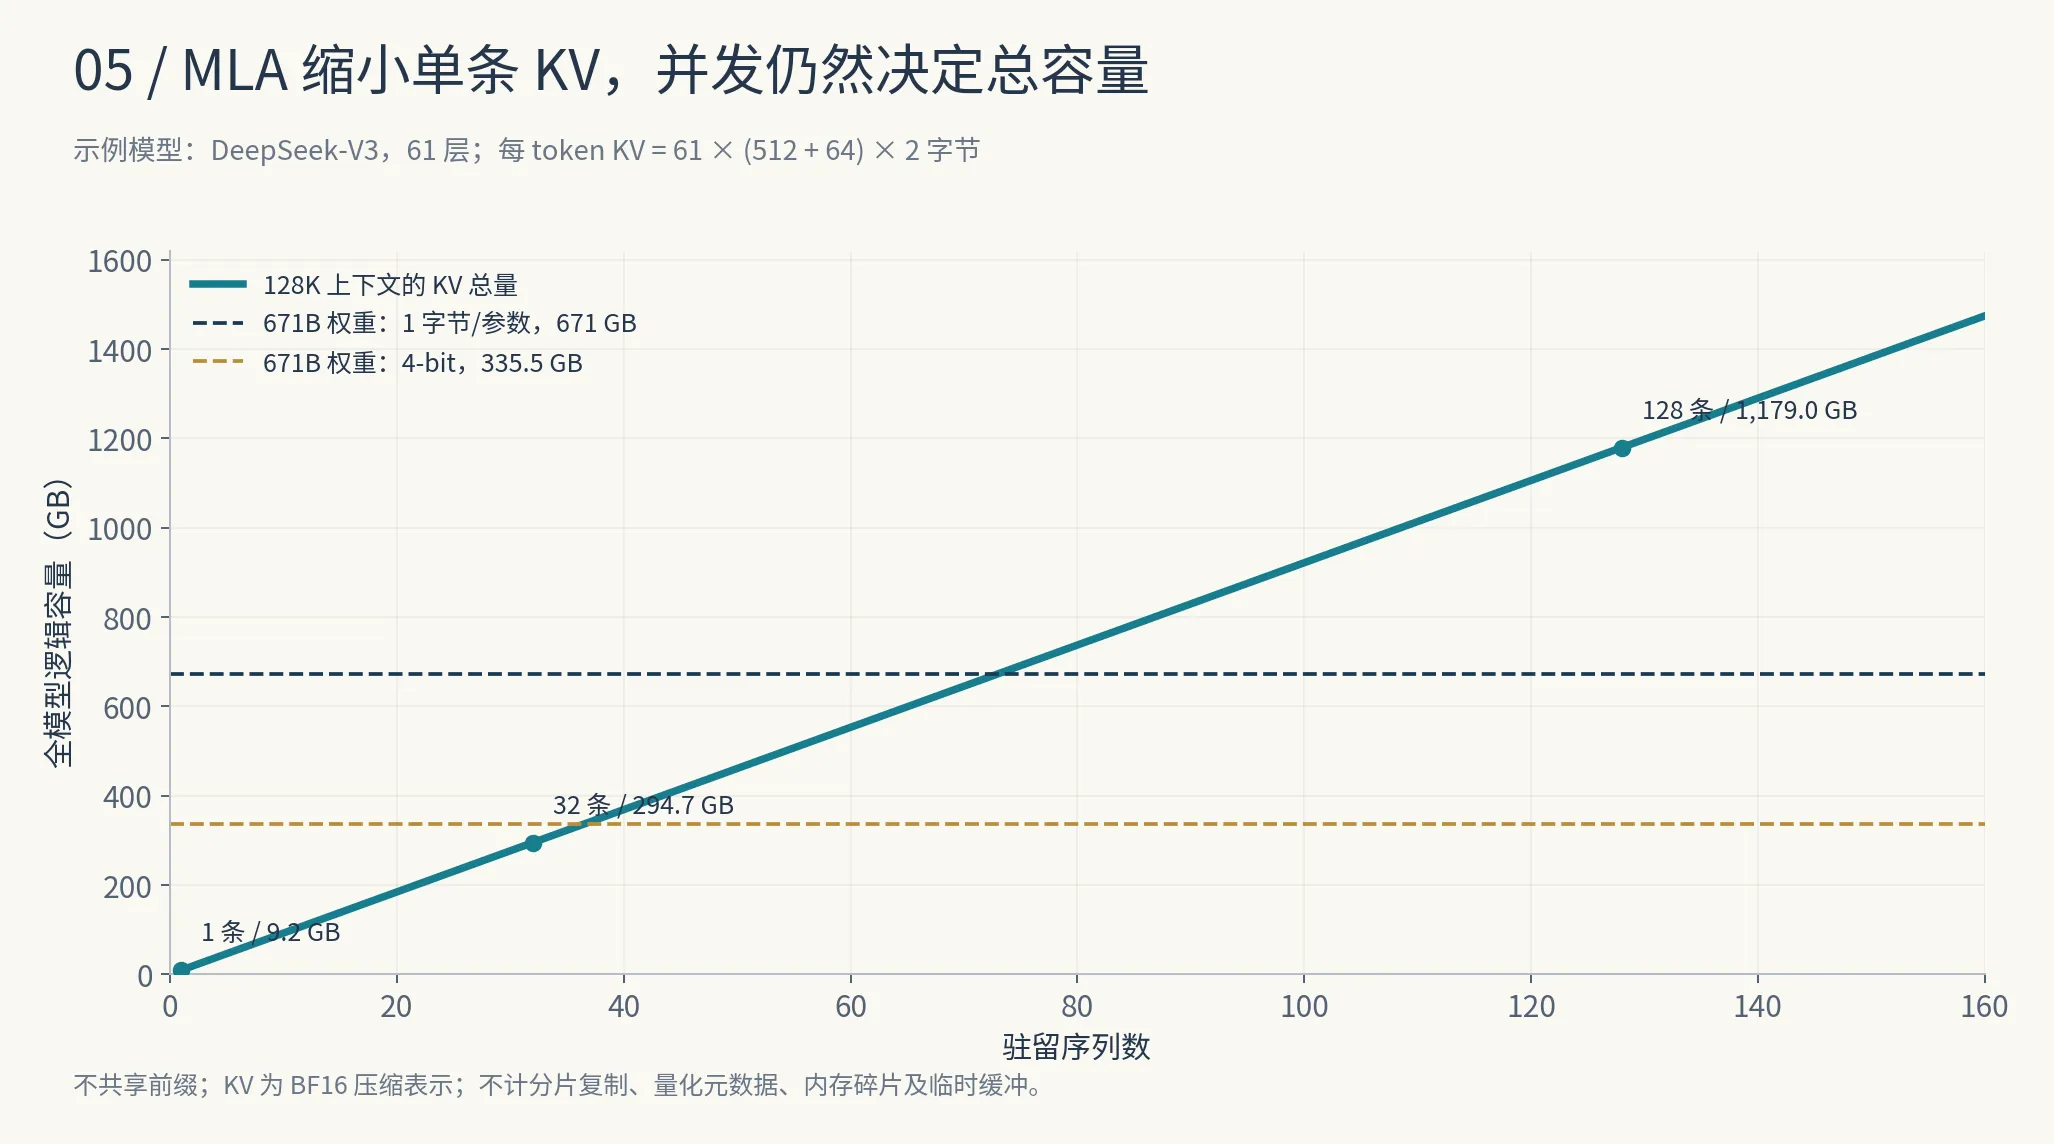
图 5|DeepSeek-V3 的全模型逻辑 KV 容量随并发增长。示例采用 128K 上下文、BF16 压缩 KV,不共享前缀。
MLA 因而确实减少了单位请求对内存的需求,却不能消除并发带来的容量压力。对 HBF 来说,它的影响也有两个方面:在相同任务和并发下,额外扩容的必要性下降;与此同时,新 KV 的写入量减少,又可能帮助闪存满足寿命要求。我更倾向于把 MLA 看作改变采购需求的因素,最终仍要回到具体部署,判断客户还差多少容量,以及补足这些容量需要多少钱。
权重量化也遵循类似的逻辑。参数从一字节压到半字节以后,模型占用和读取流量都会减少,有些模型因此可以放进现有 HBM,有些则更容易利用 HBF 完成推理。压缩比例本身无法给出商业结论,但它不断改变着 HBF 原先准备服务的容量缺口,这对一种需要专门适配的硬件并非好消息。
另一方面,MoE 的大量只读专家权重,是我认为最有力的 HBF 应用理由。总参数很大,单个 token 却只调用其中少数专家,确实值得考虑把部分权重放在更便宜的容量层。问题是,专家选择通常依赖当前层的输入状态:等路由结果出来再读取,需要付出等待时间;提前预测,则可能读错数据,增加传输量和缓存占用。
增加批次可以让读取与计算更容易重叠,但同一批 token 调用的专家也会越来越多。设一层有 256 个专家,每个 token 均匀选择 8 个,且不同 token 的选择相互独立,那么 32 个 token 合起来,期望会调用约 64% 的专家;128 个 token 时,这个比例接近 98%。这是一个说明性模型,但足以说明,单 token 的稀疏比例不能直接代表整个批次的访问情况。
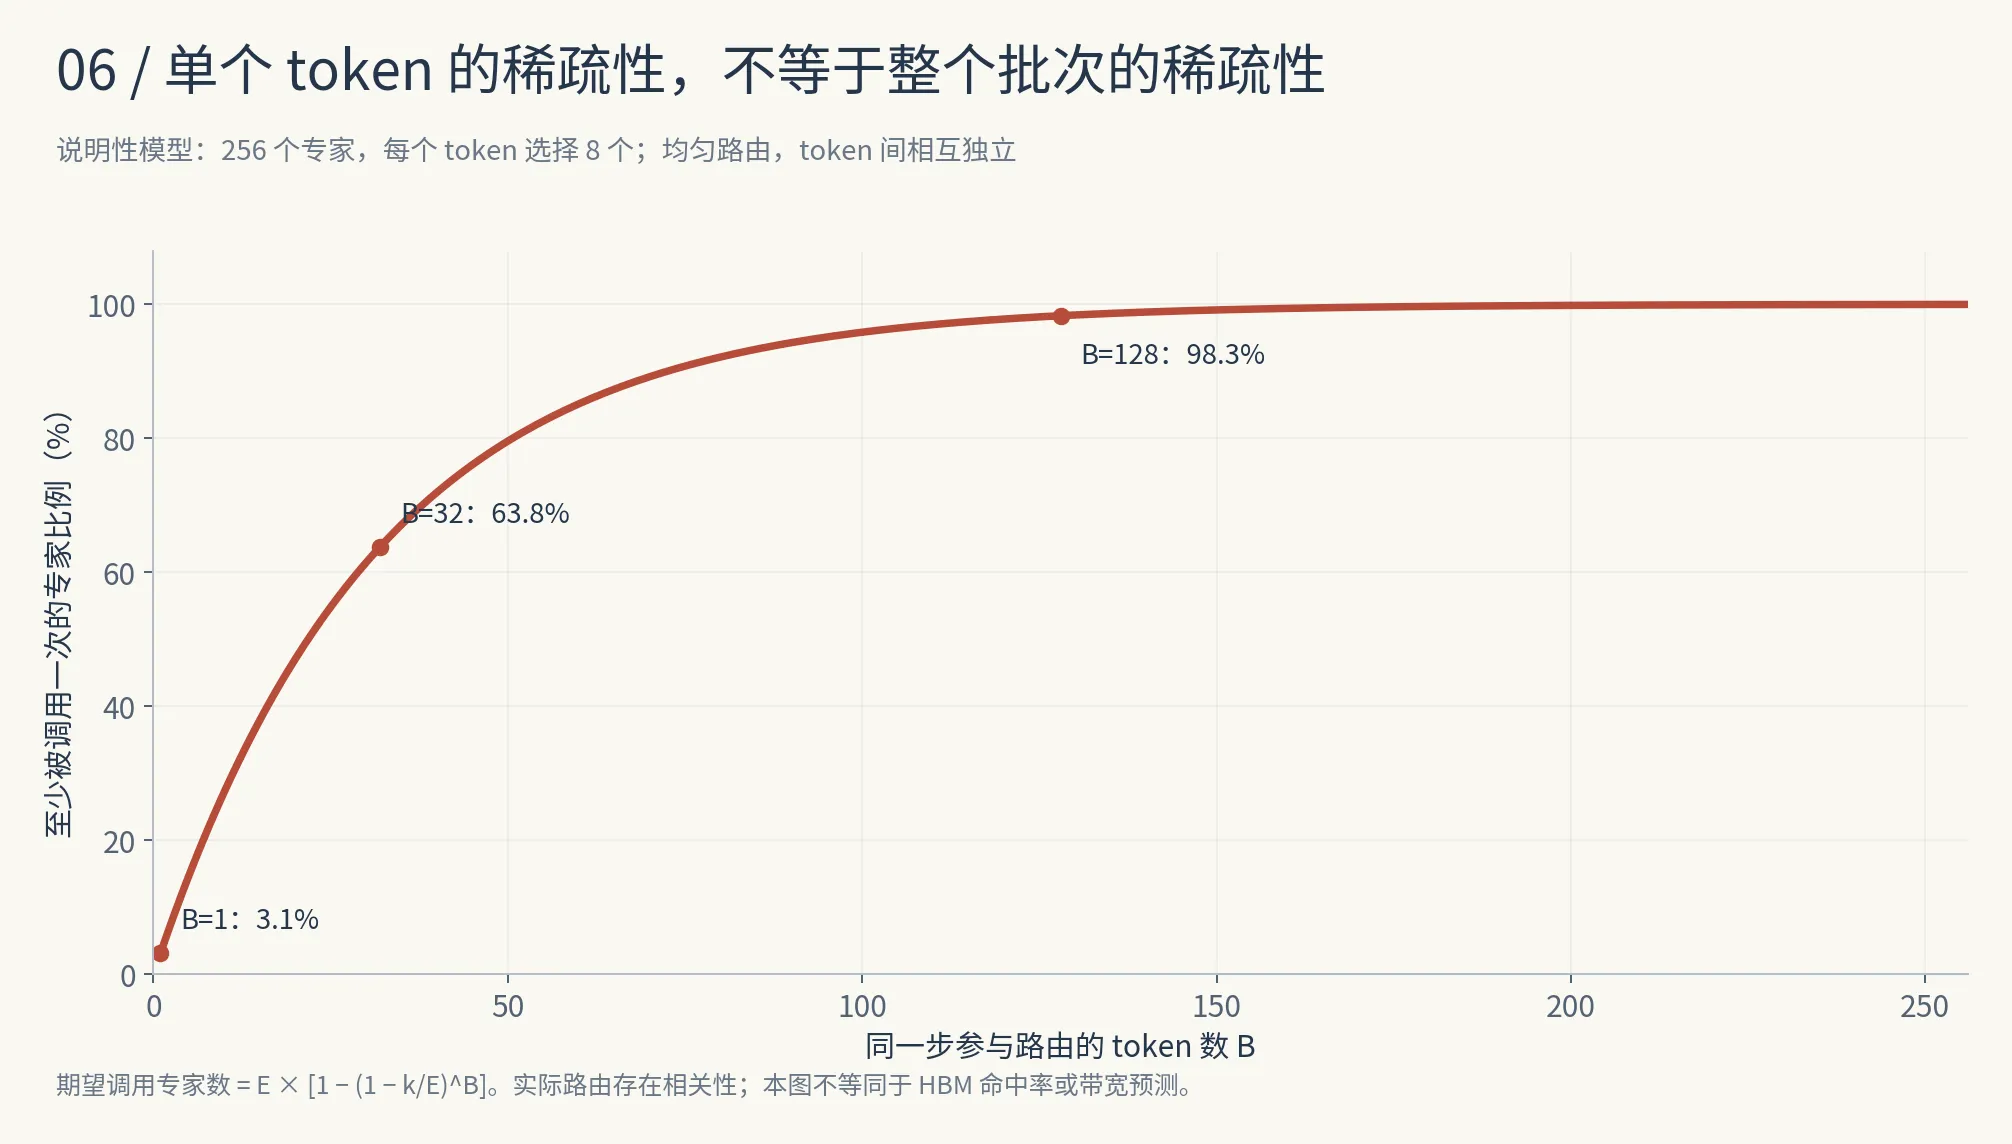
图 6|均匀、独立路由假设下,批次增大时被调用的专家比例。实际模型的路由分布可能不同。
这给系统设计带来了一组相互牵制的选择。小批次使用的专家少,却更难靠大量计算掩盖读取延迟;大批次提高了并行度,也扩大了需要访问的权重集合。专家缓存究竟能减少多少 HBF 读取,需要结合真实路由和缓存容量来判断,不能只拿总参数与激活参数的比例作依据。
同样,装下全部权重也不意味着可以按比例减少 GPU。服务器还要满足计算、带宽和通信要求,即使容量限制得到缓解,这些工作仍然可能需要相同数量的加速器。只有当内存容量确实决定了设备数量,HBF 的额外容量才容易转化为整机节省;其他情况下,它可能只是让设备存下更多暂时用不到的参数。
长上下文也应该放进这套分析。RULER 等评估说明,标称长度与实际任务表现之间存在差距,而且差距随模型和任务变化。随着能力继续进步,我更关心的是,新增上下文中有多少状态需要反复读取,又有多少可以在暂时不用时迁走。模型能够接收很长的输入,并不要求所有历史状态都始终占据加速器附近的内存。
便宜的内存,未必带来便宜的推理
把这些问题放在一起,HBF 的价值最终要体现在整套服务上:在相同模型质量和延迟要求下,能不能用更低成本完成更多请求。首 token 延迟影响多久开始回答,逐 token 延迟影响生成速度,尾延迟则关系到最慢的一批请求。总吞吐增加了多少,只有结合这些服务要求才有意义。
我会用满足时限的有效吞吐来衡量这笔账。假设新系统的全生命周期成本下降 20%,但符合时限要求的吞吐下降 30%,那么每个有效输出 token 的成本反而增加约 14%。客户采购的是能够稳定交付的推理能力,因此单个内存器件便宜多少,必须和整机损失或增加的性能一起计算。
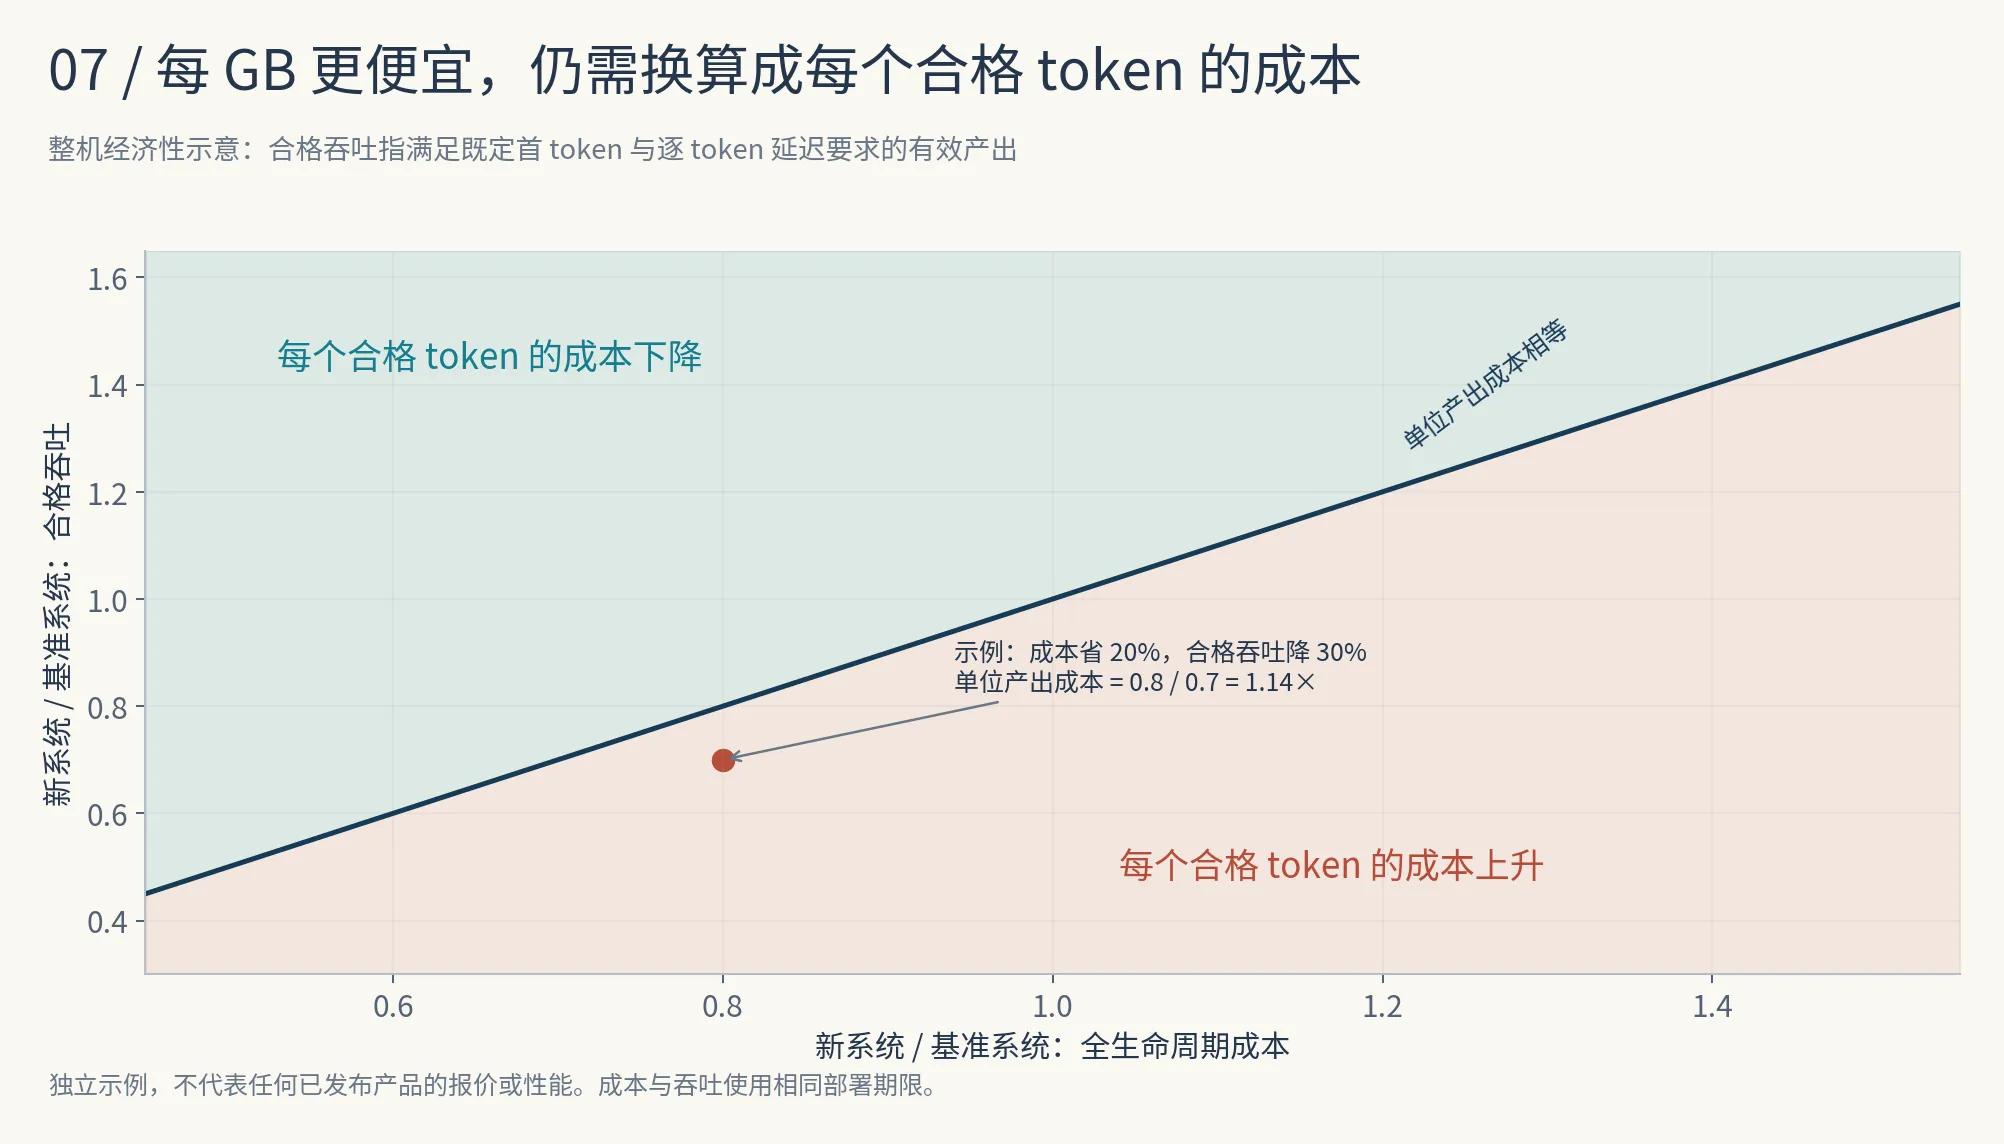
图 7|成本与有效吞吐共同决定单位产出成本。这里的合格吞吐指满足既定延迟要求的产出,数值为独立示例。
封装资源也有同样的问题。用 HBF 替换部分 HBM,可能减少近端容量或带宽;保留 HBM 再增加 HBF,又需要额外的面积、连接、供电与散热。级联等方案可以调整这些取舍,最终仍要与相同预算下的其他设计比较。局部的权重读取实验,很难完整反映这些影响。
客户手中的选择其实不少:增加 HBM、利用主机内存、调整批次、分开部署 prefill 和 decode,或者改变模型及其数值精度,都可能缓解眼前的问题。软件优化通常更容易先被采用。GQA 减少独立的 KV heads,MLA 保存更紧凑的状态,KV 量化降低字节数,PagedAttention 则减少分配浪费并支持前缀共享;只要其中一些方法缓解了最紧迫的容量压力,新增硬件层的采购就可能被推迟。
稀疏注意力和上下文裁剪还会进一步改变访问方式。少读取一些位置,可以减少计算和数据传输,但只有对应状态不再需要保留时,容量需求才会一起下降。如果剩下的访问更加零散,闪存页面的有效利用率反而可能降低。对 HBF 而言,软件既在减少一部分需求,也在改变剩余需求的特征。
已有的内存与存储方案也在继续改进。HBM 的容量和带宽会增长,主机内存与 CXL DRAM 可以提供封装外扩容。CXL 的实际性能取决于设备、链路和拓扑,需要与 SSD 分别评价;它背后的 DRAM 没有 NAND 的擦写寿命限制,对频繁更新的数据有直接价值。
SSD 则凭借容量成本、便于更换和跨节点共享,适合保存暂停会话或较少使用的上下文。只要能够在下一次请求到来时及时恢复,就未必值得把它们放到加速器封装附近。NVIDIA 的 CMX 已经沿着这条方向发展,通过 BlueField 和软件管理,让以太网连接的闪存成为共享 KV 缓存层。
对于多节点服务,缓存价值还取决于其他计算节点能否使用同一份数据。HBF 缩短了与某颗加速器的距离,共享存储则可能减少整个集群的重复计算,两种收益需要在同一套服务中比较。我认为,后者会覆盖相当一部分看起来需要新增近端容量的需求。
因此,HBF 想获得广泛采用,需要找到足够多同时符合几项条件的负载:HBM 扩容确实不经济,封装外方案满足不了回读时限,而经过合理的软件优化后,这个缺口仍然存在。我不认为这样的负载足以让 HBF 成为通用配置,尤其是在替代方案持续改善的情况下。
推理架构还有其他选择
Groq、Cerebras 和 Taalas 让这场竞争更加复杂。它们采用不同方式减少推理中的数据搬运,有的改变内存分工,有的改变模型在硬件上的实现方式。对 HBF 来说,这意味着即使客户愿意重新设计系统,也未必会选择增加一层闪存。
Groq 依靠片上 SRAM 和确定性执行追求低延迟。SRAM 读取快、带宽高,但容量和成本限制了它能够独自承担的工作,所以 NVIDIA 的 Groq 3 LPX 选择与 Rubin GPU 配合,在整套系统中结合 SRAM 和 HBM。它的价值在于把不同推理任务交给更适合的硬件,改善关键步骤的数据供给。
Cerebras 通过晶圆级芯片提供更大的片上 SRAM 空间,减少权重读取对外部内存的依赖;当模型超出单片容量时,再通过系统设计安排计算、权重和通信。Taalas 则把特定模型做进专用芯片,HC1 的公开演示针对 Llama 3.1 8B。这条路线需要足够稳定的模型和足够大的部署量,来摊销专用设计的成本,也因此具有不同的适用范围。
| 路线 | 主要改善什么 | 主要成本与限制 | 与 HBF 的竞争关系 |
|---|---|---|---|
| HBM 与常规 GPU 演进 | 通用计算、带宽和动态数据访问 | 高性能 DRAM 与先进封装成本 | 减少部分额外扩容需求 |
| 主机内存、CXL、共享 SSD | 低成本扩容和跨节点复用 | 访问路径、链路及软件管理 | 满足恢复时间较宽松的需求 |
| Groq / SRAM 协同 | 低延迟解码与数据供给 | SRAM 容量、互连和任务调度 | 改变推理任务的内存分工 |
| Cerebras | 片上权重访问与晶圆内计算 | 晶圆级制造及系统扩展 | 改变计算、权重与通信的安排 |
| Taalas | 特定模型的专用推理 | 更新灵活性与专用设计成本 | 减少特定模型对通用权重存储的依赖 |
这些路线有的与 HBM 协同,有的只适合特定模型,但都在争取以更低成本完成推理。HBF 面对的因此是一组不断变化的系统选择,而模型表示、请求特征和服务方式还可能比硬件更新得更快。对于一种需要明确的数据布局和调度配合才能发挥优势的内存,这种变化本身就会提高采用门槛。
HBF 已经获得了生态参与者的关注。2026 年 8 月,Sandisk 与 SK hynix 宣布发布首份 OCP 技术规范,Google 和 Tenstorrent 参与了联盟和标准化。这足以说明它并非只有存储厂商支持,但参与标准、验证技术与大规模部署之间,仍然隔着产品选择和成本比较。
我更想看到的是同一套可交付配置的整机结果:采用什么介质,保留多少 HBM,在实际负载下持续完成多少符合时限的请求,以及几年运行下来要付出多少成本。这些指标能够回答客户是否应该购买,也能区分技术上可行的设计与值得普遍采用的产品。
我看空 HBF 成为主流,原因也正在这里。最需要靠近计算的数据,对延迟和读写能力的要求通常最严格;容易迁走的数据,又往往可以使用成本更低、共享更方便的内存或存储。HBF 必须从中找到足够多既需要它、又适合它的数据,并用整机收益证明这种安排值得长期保留。
我预计 HBF 会有产品,也会有客户,但在通用推理平台上,我更看好 HBM、封装外容量和软件优化继续配合演进。几百 GB 的额外容量确实能解决某些部署问题,要把它推广成普遍需求,还需要证明它能够持续降低整套服务的成本。现有的容量承诺与读取模拟,离这个结论仍然很远。
参考资料
- Sandisk, High Bandwidth Flash Fact Sheet, July 2025
- SK hynix, H³: Hybrid Architecture Using High Bandwidth Memory and High Bandwidth Flash for Cost-Efficient LLM Inference
- Zhuoran Li et al., A Full-Stack Characterization of High-Bandwidth Flash for KV-Centric LLM Serving, arXiv:2608.11668v1
- Xinyu Wang et al., FlashAccel: Leveraging High-Bandwidth Flash for High-Throughput LLM Inference, arXiv:2607.10186v1
- DeepSeek-AI, DeepSeek-V3 Technical Report
- DeepSeek-AI, Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures
- Joshua Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- Zirui Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache
- Woosuk Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention
- Cheng-Ping Hsieh et al., RULER: What’s the Real Context Size of Your Long-Context Language Models?
- CXL Consortium, Overcoming the AI Memory Wall: How CXL Memory Pooling Powers the Next Leap in Scalable AI Computing
- NVIDIA CMX Context Memory Storage Platform
- NVIDIA Groq 3 LPX
- Cerebras, Introducing Cerebras Inference: AI at Instant Speed
- Taalas Products;Taalas 技术方向
- Sandisk and SK hynix Advance Global Standardization of High Bandwidth Flash with Release of First OCP Technical Specification, August 3, 2026
- Yu Cai et al., Error Characterization, Mitigation, and Recovery in Flash Memory Based Solid-State Drives